【比較】通常のクラウドLLMと何が違うのか?
「クラウドLLM(OpenAI/Gemini等)をそのまま使う」ことと、「KAI Patent Layer を接続する」ことには、セキュリティ・コスト・運用面で決定的な違いがあります。
1. データの安全性が違う(機密保持・漏洩防止)
- 通常のクラウドLLM: プロンプトに入力した社内文書や顧客データがそのままクラウドへ送信されます。
- KAI Patent Layer: KAIが処理するのはテキストそのものの閲覧・蓄積ではなく、特許技術(観時性理論)に基づく「ハルシネーション検出・シグナル解析」のみ。極めて安全なデータ設計で運用可能です。
2. コストとレスポンスの桁が違う(ローカル/軽量LLMの覚醒)
- 通常のクラウドLLM: 毎回のテキスト生成ごとに高額なAPI従量課金や利用制限(429 Rate Limit)が発生します。
- KAI + ローカルLLM: オンプレミスやローカル環境の軽量モデル(Gemma 3 4B等)と組み合わせることで、APIコストを大幅削減。単体では「すべてハルシネーション」と判定してしまう軽量AIを、KAIが実用レベルの高度な検知器へ進化させます。
3. ベンダーロックインの回避 特定の巨大クラウドAI企業に依存せず、自社のローカルモデルや最新のオープンLLMをいつでも自由に着脱・制御できます。
【公式発表】基幹技術「位相非線形蓄積システム」の特許設定登録(特許第7867310号)完了のお知らせ
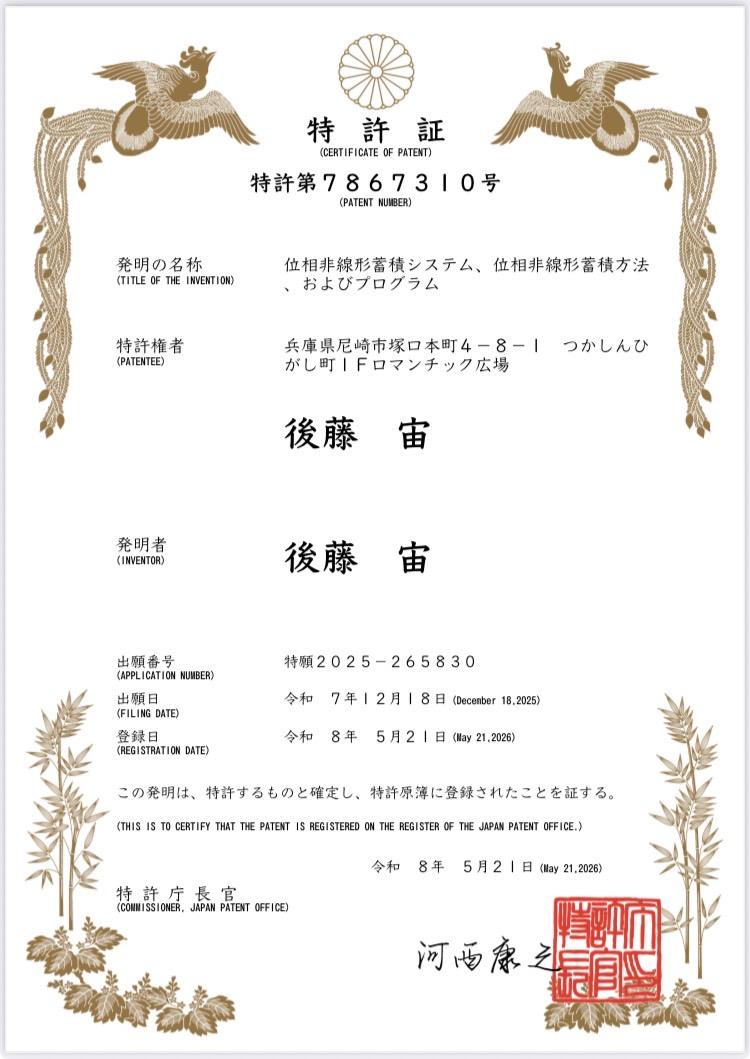
【基幹特許技術】位相非線形蓄積システム(特許第7867310号) KAI Patent Layerは、独自の観時性理論(PNA)に基づく基幹特許(特許第7867310号)を搭載したハルシネーション制御レイヤーです。
- 量子数理×LLMのリアルタイム制御(請求項1, 13) 情報を複素波動関数(観時場)としてモデル化し、LLM応答を「知識波」として時間発展・フィードバックさせる自律ループ構造を構築。
- 多次元評価による自動防衛(請求項8) 構造的秩序度・意味的整合性・収束密度等の多次元スコアリングにより、誤回答をリアルタイムに遮断。
- 自己進化型ルール調整(請求項12) 時系列変化に応じてシステム自らがハミルトニアンやポテンシャル項を動的に最適化。
※実証実験においてシャノンエントロピー1.005を記録し、データの不確実性を極限まで制御することに成功しています。
生成AIのハルシネーション(誤回答)を物理的に遮断
KAI Patent Layer は、独自理論(観時性理論・複素波動関数)に基づき、LLMが出力する不確実な数値や嘘の情報をリアルタイムに検知・正規化する検問レイヤーAPIです。
導入により解決できる課題
1. 誤情報の完全遮断
根拠のない数値や変数の推測回答(ハルシネーション)をAPIレベルで検知。不確実な場合は安全に回答不可として遮断します。
2. 公的データとの両立
厚生労働省などの公的・確定データは正確にレスポンスしつつ、企業独自のコンテクスト(ブランディング)も正確に保持します。
3. 監査ログ(説明責任)
毎ターンのエントロピーや確信度(PNA Score)をJSONで出力。法人のリスク管理・コンプライアンス監査に対応します。
API Quick Start(実装例)
標準的な REST API(JSON / HTTP POST)のため、Python、Node.js、cURLなどあらゆる環境から数行で呼び出せます。
リクエスト例(HTTP POST)
POST https://api.phiai.net/v1/verify
Content-Type: application/json
Authorization: Bearer YOUR_API_KEY

{
  "prompt": "梅干し1個あたりの塩分量は何gですか?",
  "context": "栄養学ガイドライン"
}
レスポンス例(JSON)
{
  "status": "success",
  "pna_score": 0.99,
  "entropy": "normalized",
  "data": {
    "verified_response": "梅干しの塩分量はサイズや製法(減塩等)により変動するため、確証のある数値データを持ち合わせておりません。一般的な塩分目標量は男性7.5g未満、女性6.5g未満です。"
  }
}